

 Bahasa Indonesia
 Deutsch
 English
 Français
 Português (Brasil)
 Türkçe
 ไทย
 中文(简体)
 中文(繁體)
 日本語
 한국어
Marcas en las paredes
Qué tiene que hacer el robot
Sección titulada «Qué tiene que hacer el robot»Las marcas en las paredes (wall tokens) suponen la mayor parte de tus puntos, y cada informe erróneo cuesta 5 puntos. Así que, por cada marca que encuentres, tienes que decidir entre:
| Es… | Qué hacer |
|---|---|
| Una víctima de letra (Letter victim: Φ, Ψ, Ω) | Envía H, S o U |
| Una víctima falsa (Fake victim: los mismos símbolos, en tres dimensiones) | No informes de ella y déjala fuera del mapa |
| Un objetivo cognitivo (Cognitive target) con una suma de 0 a 3 | Envía F, P, C u O |
| Un objetivo cognitivo con cualquier otra suma | Es falso: no informes de él y déjalo fuera del mapa |
Consulta las Reglas para ver las definiciones exactas, y Comunicación para saber cómo enviar el informe.
Lo que ve la cámara
Sección titulada «Lo que ve la cámara»La cámara del robot inicial tiene 64 × 40 píxeles. Con esa resolución, una marca ocupa solo unos pocos píxeles hasta que el robot está cerca, así que lo mejor es buscar candidatas desde lejos y luego acercarse para leerlas. Recuerda que un informe exige que el robot esté a menos de media baldosa de la marca, y que las cámaras personalizadas pueden tener más resolución, a cambio de un coste.
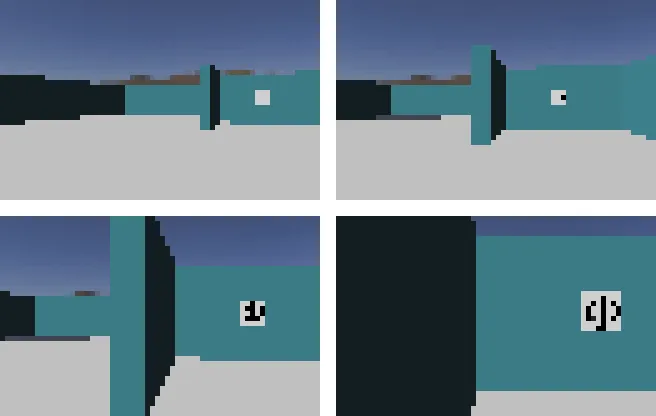

Las víctimas de letra son símbolos negros sobre un cuadrado blanco, y pueden estar giradas en cualquier ángulo, así que tu método no debe depender de la orientación.
Leer un objetivo cognitivo
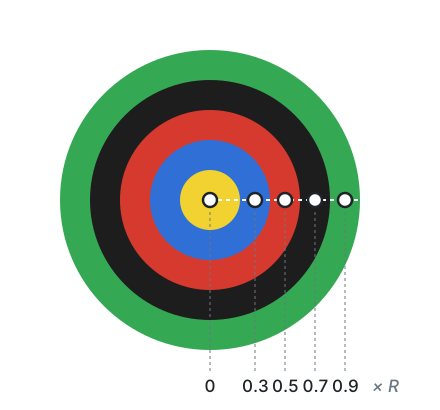
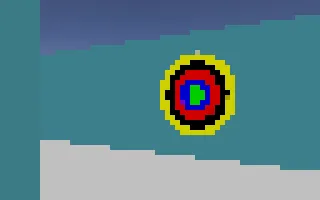
Sección titulada «Leer un objetivo cognitivo»Un objetivo cognitivo está formado por cinco partes concéntricas, así que no hace falta reconocer su forma: cuando hayas encontrado su centro y su radio exterior, puedes tomar una muestra del color en el centro de cada parte. Las partes tienen radios de 0,5, 1, 1,5, 2 y 2,5 cm, así que sus puntos medios están a 0, 0,3, 0,5, 0,7 y 0,9 del radio exterior.
Esta función lo hace con OpenCV en Python. Para encontrar el centro y el radio, puedes usar por ejemplo el contorno del objetivo, como en Recorre el laberinto.
import cv2 as cvimport numpy as np
# Colour of each part in BGR order, as seen by the cameraCOLORS = {    'K': (0, 0, 0),      # Black    'R': (0, 0, 255),    # Red    'Y': (0, 255, 255),  # Yellow    'G': (0, 255, 0),    # Green    'B': (255, 0, 0),    # Blue}
def nearestColor(bgr):    # Returns the name of the colour that is closest to a pixel    distances = {name: np.linalg.norm(np.array(color) - bgr) for name, color in COLORS.items()}    return min(distances, key=distances.get)
def readRings(image, centerX, centerY, radius):    # image is a BGR image, as in the RGB Camera tutorial    # Returns the 5 colours from the center outwards, for example ['Y', 'B', 'R', 'K', 'G']    rings = []    for position in [0, 0.3, 0.5, 0.7, 0.9]:        x = int(round(centerX + position * radius))        y = int(round(centerY))        rings.append(nearestColor(image[y, x].astype(float)))    return rings
En una ejecución real, puede que el objetivo se vea en ángulo, y entonces parece una elipse. Ponerte delante de él, tomar como aviso los colores que parezcan incorrectos o leer varios fotogramas hará que el resultado sea más fiable.
Calcular el tipo
Sección titulada «Calcular el tipo»Cuando tengas los cinco colores, el código que debes enviar se obtiene de su suma. Cada una de las cinco partes cuenta siempre, aunque los colores vecinos sean iguales.
VALUES = {'K': -2, 'R': -1, 'Y': 0, 'G': 1, 'B': 2}CODES = {0: 'F', 1: 'P', 2: 'C', 3: 'O'}
def targetCode(rings):    # rings is the list of the 5 colours of the target    # Returns the code to report, or None if the target is fake    total = sum(VALUES[color] for color in rings)    return CODES.get(total)
#include <map>#include <vector>
using namespace std;
// rings has the 5 colours of the target: 'K', 'R', 'Y', 'G' or 'B'// Returns the code to report, or 0 if the target is fakechar targetCode(const vector<char>& rings) { map<char, int> values = {{'K', -2}, {'R', -1}, {'Y', 0}, {'G', 1}, {'B', 2}}; int total = 0; for (char color : rings) total += values[color];
switch (total) { case 0: return 'F'; case 1: return 'P'; case 2: return 'C'; case 3: return 'O'; default: return 0; }}Por ejemplo, ['Y', 'B', 'R', 'K', 'G'] suma 0, así que es F, y ['B', 'Y', 'K', 'K', 'K'] suma -4, así que es falso.
Detectar víctimas falsas
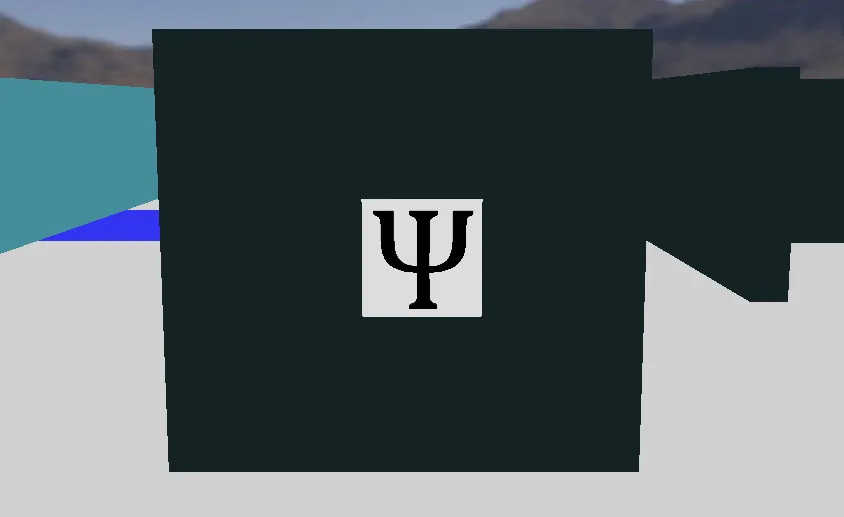
Sección titulada «Detectar víctimas falsas»Las víctimas falsas muestran los mismos símbolos que las reales, pero las letras son tridimensionales. Desde el frente, puede que una cámara sola no consiga distinguirlas:
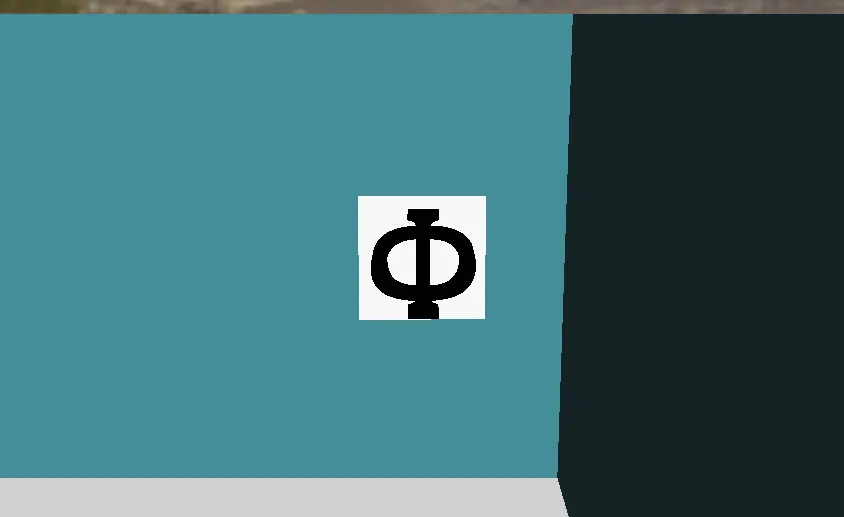
Las reglas indican que la profundidad se puede detectar con uno de los sensores disponibles en el Robot Customizer. Algunas ideas para explorar:
- Compara medidas de distancia tomadas a lo largo de la marca, con un lidar o con sensores de distancia, para buscar una diferencia de altura.
- Mira la marca desde un ángulo, donde un relieve cambia la forma del símbolo.
Los mundos world3.wbt y world4.wbt incluyen víctimas falsas, y el World Editor puede añadirlas a tus propios mapas. Erebus también incluye el script scripts/update_maps_with_fakes.py, que convierte al azar en falsas las víctimas de mundos existentes.
Informar de una falsa cuesta 5 puntos como identificación errónea, mientras que una víctima real en una baldosa lineal vale 15 puntos con su tipo en el área 1, y más en otras áreas. Tenlo en cuenta cuando decidas lo seguro que debe estar tu robot antes de informar.

Erebus forma parte de RoboCupJunior Rescue.
Noticias, eventos y documentos de equipos: sitio web de la comunidad RCJ Rescue
© 2020–2026 Erebus Development Team